전체 글
2,168개의 글
llama.cpp 라우터로 GGUF 여러 개 서빙하기
로컬에서 모델을 여러 개 돌리다 보면 모델마다 llama-server 프로세스를 따로 띄우고 포트를 나눠 쓰게 된다. 채팅용, 코드용, 임베딩용으로 세 개를 올려 두면 쓰지도 않는 모델이 VRAM을…
 stdio.h·2026년 11월 10일·조회 0
Claude 토큰 절약하는 법
Claude를 쓰다 보면 생각보다 사용량 한도가 빨리 차는 날이 있습니다. API로 서비스를 만들고 있다면 청구서가 예상보다 크게 나오기도 합니다. 작업이 복잡해서만은 아니고, 긴 대화 기록을 끌고…
AI 공격 시대의 서버 운영 점검
요즘은 코드를 짜거나 장애 원인을 찾을 때 AI를 쓰는 일이 흔해졌습니다. 그런데 이 도구를 반기는 쪽이 개발자와 운영자만은 아닙니다. 공격자도 같은 도구로 같은 일을 하기 시작했고, 서버를 맡고 …
 강철지그·2026년 11월 9일·조회 1
PostgreSQL 18 비동기 I/O 켜기
PostgreSQL 운영 글을 쓰다 보면 디스크 읽기가 느린 환경에서 순차 스캔과 VACUUM이 CPU는 놀면서 I/O 대기만 쌓이는 경우를 자주 만난다. PostgreSQL 18이 정식으로 나오면…
 Hardware
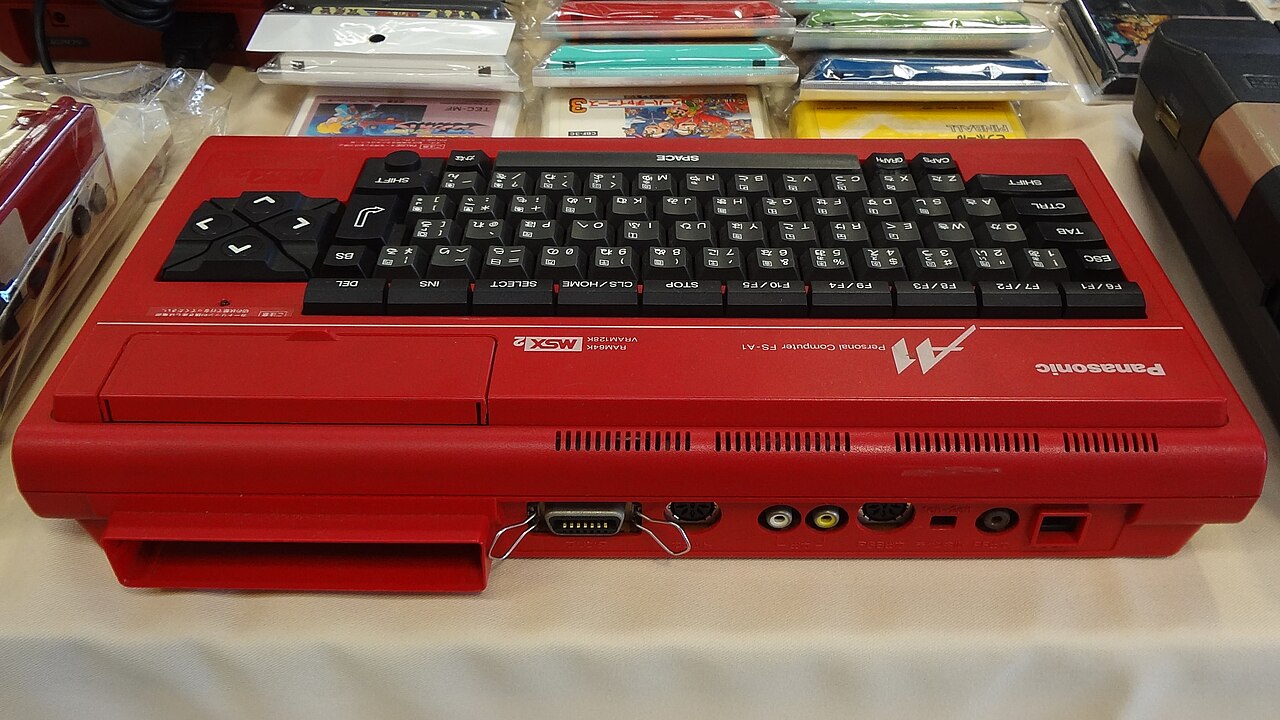
파나소닉 FS-A1을 openMSX로 되살리기
MSX를 다룬 글을 몇 편 쓰다 보면 FS-A1 이야기를 피하기 어렵다. 1985년 MSX2 규격이 나왔을 때 초기 기종들은 비쌌고, 가정에 들이기엔 부담스러운 물건이었다. 그 분위기를 바꾼 게 1…
 동교동삼거리·2026년 11월 8일·조회 2
로컬 임베딩 API로 RAG 검색 붙이기
RAG 파이프라인을 짜다 보면 가장 먼저 걸리는 게 임베딩 비용이다. 문서 수십만 건을 한 번 색인하고 끝이면 모르겠는데, 게시판처럼 글이 계속 쌓이는 서비스는 임베딩 호출이 끊기지 않는다. 사내 …
stdio.h·2026년 11월 8일·조회 1Velero로 클러스터 간 백업과 복구하기
쿠버네티스를 몇 년 굴리다 보면 "이 클러스터가 통째로 날아가면 뭘로 되살리지"라는 질문을 한 번은 마주하게 된다. etcd 스냅샷만으로는 영속 볼륨(PV) 데이터가 돌아오지 않고, GitOps로 …
vLLM에서 유효한 JSON만 뱉게 만들기
LLM으로 분류 결과나 추출 데이터를 받아 파이프라인에 넘기는 서비스를 운영하다 보면, 모델이 가끔 JSON 앞에 "물론이죠, 아래가 결과입니다" 같은 말을 붙이거나 마지막 중괄호를 빼먹는다. 프롬…
PostgreSQL 17 네이티브 증분 백업
매일 밤 pg_basebackup 으로 전체 클러스터를 통째로 복사하던 운영 서버가 있었다. 데이터가 수백 GB로 불어나니 백업 한 번에 디스크와 네트워크가 꽤 오래 묶였다. 그동안은 WAL 아카이…
NIM Operator로 LLM 추론 선언형으로 배포하기
GPU 노드에 LLM 추론을 올릴 때 Deployment와 Service, PVC, ConfigMap, HPA를 손으로 엮다 보면 모델 하나 올리는 데 매니페스트가 대여섯 개로 불어난다. 모델 가중…
 Hardware
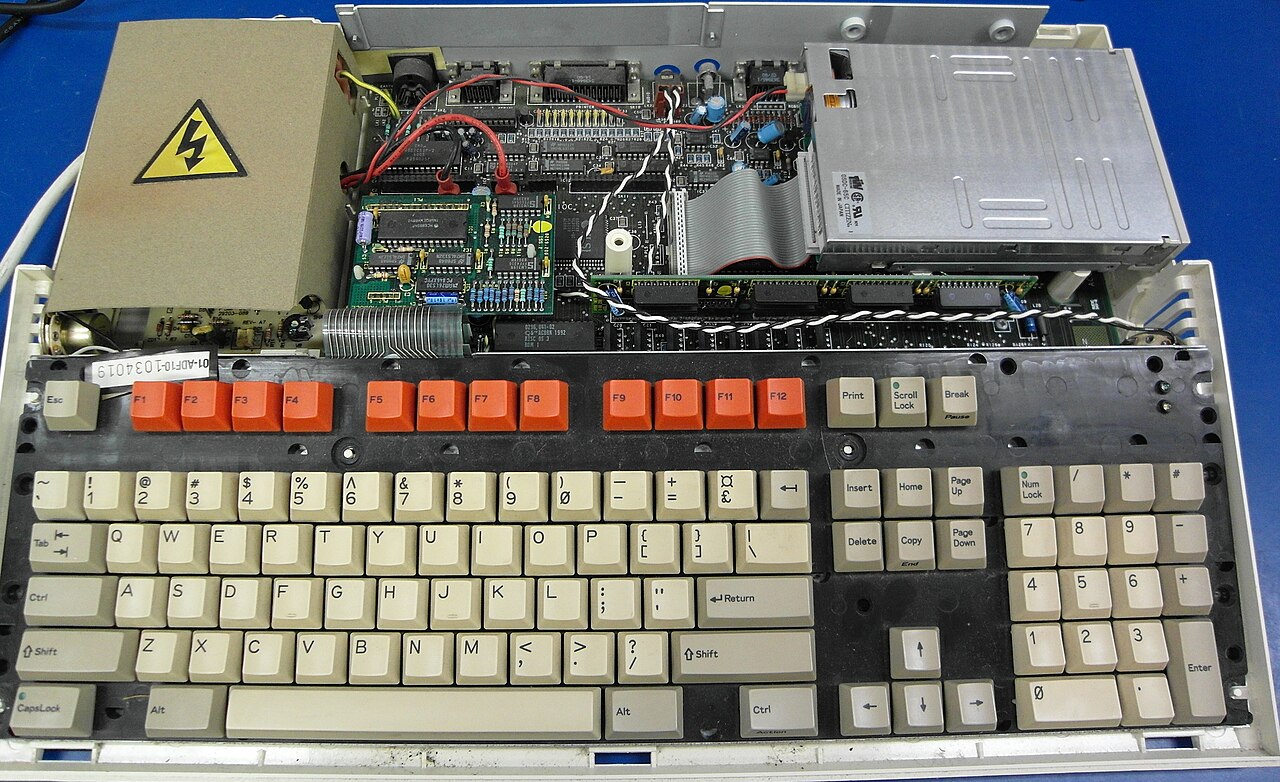
Acorn A3000를 Arculator로 다시 켜기
요즘 스마트폰부터 노트북까지 거의 모든 기기에 ARM 코어가 들어간다. 그 ARM이 처음 데스크톱 컴퓨터의 메인 CPU로 들어간 기계가 에이콘 아르키메데스 계열이고, 그중 가장 대중적으로 팔린 모델…
동교동삼거리·2026년 11월 6일·조회 4SLO 기반 자율 운영, 에러 버짓으로 판단하기
알림이 모자랐던 게 아니라 판단 기준이 없었다 대부분의 운영 조직은 이미 많은 것을 자동화했다. 오토스케일링, 헬스 체크에 따른 재시작, CI/CD가 일상적으로 돌아간다. 그런데도 새벽 3시에 사람…
llama.cpp로 로컬에 비전 모델 서빙하기
로컬에서 LLM을 돌릴 때 llama.cpp를 쓰는 사람은 많은데, 이미지를 넣는 멀티모달 쪽은 한동안 손이 잘 안 갔다. 예전엔 llava용 바이너리, clip 변환 스크립트가 모델마다 따로 있어…
stdio.h·2026년 11월 5일·조회 1vLLM KV 캐시를 CPU와 NVMe로 오프로딩하기
GPU 한 장으로 챗봇을 돌리다 보면 동시 접속이 조금만 늘어도 TTFT가 늘어지는 지점이 온다. 긴 시스템 프롬프트에 멀티턴 대화, 거기에 RAG로 끌어온 문서까지 매번 다시 prefill하면 G…
AWS HealthOmics Run Analyzer로 워크플로 비용과 성능 최적화하기
왜 Run Analyzer인가 AWS HealthOmics Run Analyzer는 이미 끝난 워크플로 실행(run)의 태스크별 리소스 사용량을 분석해서, 실제 사용량을 기준으로 CPU·메모리 요청…
SGLang과 vLLM 중 무엇을 쓸까
요즘 LLM 서빙 엔진을 고르다 보면 거의 vLLM과 SGLang 둘로 좁혀진다. 예전에 vLLM EAGLE3로 처리량 끌어올리는 글을 쓴 적이 있는데, 그때 댓글이고 사내 메신저고 "RAG 챗봇은…
DCGM Exporter로 쿠버네티스 GPU 모니터링
GPU 노드를 쿠버네티스에 붙여 놓고 나면 다음 질문은 항상 같다. 저 비싼 카드가 지금 얼마나 일하고 있나, 어느 파드가 메모리를 다 먹고 있나, 혹시 조용히 맛이 가고 있는 건 아닌가. CPU야…
MCP 서버에 OAuth 2.1 붙이기
로컬에서 stdio로 돌리던 MCP 서버를 사내망 밖으로 꺼내 HTTP로 열려고 하면 제일 먼저 막히는 게 인증이다. stdio는 프로세스를 띄운 쪽이 이미 신뢰 경계 안에 있으니 환경변수로 토큰만…
Dynamo로 vLLM prefill과 decode 나누기
GPU로 LLM을 서빙하는 글을 몇 번 썼다. 쿠버네티스에 vLLM을 올리는 것부터 EAGLE3 같은 추측 디코딩으로 처리량을 끌어올리는 것까지. 그런데 막상 운영에 넣어 보면 반복해서 걸리는 지점…
WAF와 EDR의 차이
보안 점검 회의에 들어가면 WAF와 EDR이 같은 줄에 묶여 나오는 일이 잦다. 둘 다 세 글자 보안 제품이고 둘 다 공격을 막는다고 소개되니, 하나만 있으면 되지 않느냐는 말도 따라 나온다. 서버…
강철지그·2026년 11월 2일·조회 5Ingress를 Gateway API로 무중단 전환하기
ingress-nginx가 읽기 전용으로 넘어간 뒤로 "그래서 뭘 깔아야 하냐"는 질문은 한 번 받고 끝났다. 요즘 받는 질문은 다르다. 이미 Ingress 리소스 수십 개가 돌아가는 클러스터를 멈…
쿠버네티스 GPU를 여러 파드가 나눠 쓰기
GPU 노드는 비싸다. 그런데 막상 붙여 보면 추론 서비스 하나나 주피터 노트북 하나가 카드 한 장을 통째로 잡고 있으면서 실제 사용률은 한 자릿수에 머무는 경우가 흔하다. Azure의 NC/ND …
vLLM EAGLE3로 추론 처리량 끌어올리기
로컬이나 사내 GPU에서 LLM을 서빙하다 보면 지연 시간에 먼저 발목이 잡힌다. 모델을 더 키우긴 어렵고 GPU를 더 붙이자니 비용이 걸린다. 이럴 때 손대볼 만한 게 추측 디코딩(speculat…
OrcaRouter, 모델 200개를 잇는 게이트웨이
OrcaRouter(orcarouter.ai)는 OpenAI 호환 주소 하나로 200개가 넘는 AI 모델을 호출하게 해 주는 AI 게이트웨이입니다. 운영사는 Continuum AI로, 스스로를 연구…